
Anthropic ra mắt Claude Opus 5.5: Chi phí thấp hơn 40%, tốc độ nhanh hơn, bảo mật được nâng cấp và khả năng xử lý tác vụ dài mạnh mẽ hơn
TradingKey - Vào ngày 22 tháng 9 theo giờ Miền Đông Mỹ, Anthropic đã thông báo ra mắt Claude Opus 5.5, tập trung vào ba khía cạnh chính: khả năng xử lý các nhiệm vụ phức tạp mạnh mẽ hơn, chi phí vận hành thấp hơn và sử dụng an toàn hơn. So với Opus 5, chi phí xử lý nhiệm vụ của mô hình này đã giảm 40% và tốc độ đầu ra tăng hơn 30%; giá cho dữ liệu đầu vào, đầu ra và đọc bộ nhớ đệm cũng đồng thời được hạ xuống.
Điều đáng chú ý nhất về bản nâng cấp này có thể không phải là việc đứng đầu trong một bài kiểm tra hiệu năng đơn lẻ, mà là mô hình đang bắt đầu hoạt động giống như một đối tác hợp tác lâu dài hơn. Mô hình có thể xử lý việc di chuyển mã nguồn quy mô lớn, sắp xếp tài liệu kinh doanh và tạo các báo cáo phân tích, đồng thời trình bày câu trả lời một cách trực tiếp hơn và giúp việc kiểm duyệt trở nên dễ dàng hơn.
Lập trình phức tạp giúp tiết kiệm nhiều thời gian hơn
Khả năng nổi bật nhất của Opus 5.5 tập trung vào các nhiệm vụ lập trình quy mô lớn, nhiều bước đòi hỏi phải kiểm tra liên tục. Trong một bài kiểm tra, Opus 5.5 đã rà soát và sửa lỗi bộ mã nguồn 200.000 dòng trong chưa đầy 3 giờ. Trong khi đó, Opus 5 mất hơn 20 giờ và tiêu tốn gấp khoảng 2,5 lần số lượng token. Đối với các doanh nghiệp, điều này có nghĩa là giá trị của AI không chỉ nằm ở việc "liệu nó có thể viết mã hay không", mà còn ở việc liệu nó có thể tránh đi đường vòng và tiết kiệm thời gian hay không.
[Nguồn: Anthropic]
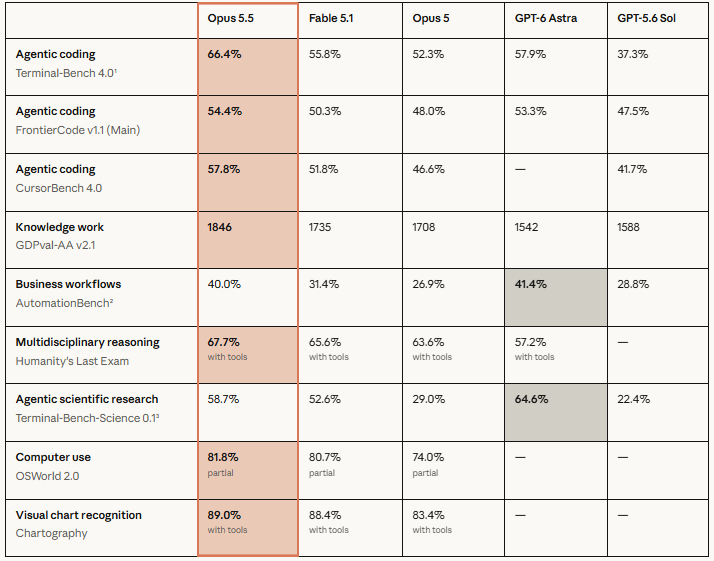
Dữ liệu thử nghiệm cũng cho thấy Opus 5.5 đạt 66,4% trên Terminal-Bench 4.0, 54,4% trên FrontierCode v1.1 và 57,8% trên CursorBench 4.0. Mặc dù các con số này không thể đại diện cho toàn bộ công việc trong thực tế, chúng cho thấy khả năng vượt trội hơn của mô hình trong việc xử lý các nhiệm vụ kéo dài và nhiều bước.
Năng lực văn phòng và nghiên cứu cũng được cải thiện
Các trường hợp sử dụng của Opus 5.5 không chỉ dừng lại ở các lập trình viên. Các bài kiểm tra của Anthropic bao quát cả quy trình kinh doanh, công việc tri thức, nghiên cứu khoa học, thao tác máy tính và nhận diện biểu đồ.
Trong bài kiểm tra công việc tri thức GDPval-AA v2.1, Opus 5.5 đạt 1.846 điểm, cao hơn mức 1.735 điểm của Fable 5.1 và 1.708 điểm của Opus 5. Trong bài kiểm tra thao tác máy tính, điểm số của mô hình đạt 81,8%, đồng thời đạt 89% trong bài kiểm tra nhận diện biểu đồ.
Một chi tiết trong các nhiệm vụ nghiên cứu đặc biệt thú vị. Những người kiểm thử đã yêu cầu nhiều mô hình viết báo cáo dựa trên thông tin báo cáo tài chính khó tìm và đối soát từng dòng số liệu cũng như trích dẫn. Opus 5.5 đã đạt tiêu chuẩn chất lượng 16 lần dưới các cấu hình khác nhau, trong khi hai mô hình còn lại không vượt qua dù chỉ một lần. Điều này chứng minh rằng mô hình chú trọng nhiều hơn vào bằng chứng khi sắp xếp thông tin, mặc dù vẫn chưa thể thay thế sự kiểm chứng của con người.
Ví dụ, công ty đầu tư Walleye Capital đã giao cho mô hình phân tích một vụ sáp nhập doanh nghiệp giả định. Nó không chỉ hoàn thành mô hình tài chính mà còn phát hiện lỗi trong hướng dẫn kiểm tra và chủ động sửa lại. Đối với người dùng thông thường, khả năng này mang lại các phân tích thị trường, việc lập ngân sách và tài liệu thuyết trình rõ ràng hơn.
Giá sụt giảm là thay đổi then chốt
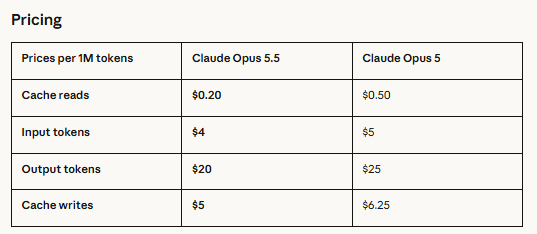
Opus 5.5 có mức giá thấp hơn Opus 5. Giá đầu vào cho mỗi triệu token đã giảm từ $5 xuống $4, giá đầu ra từ $25 xuống $20, và giá đọc bộ nhớ đệm giảm từ $0,50 xuống $0,20.
[Nguồn: Anthropic]
Đọc bộ nhớ đệm đặc biệt quan trọng đối với các tác vụ lập trình và tự động hóa dài vì nhiều quy trình làm việc thường xuyên tái sử dụng nội dung đã được xử lý trước đó. Sau đợt giảm giá này, các đội ngũ phát triển có thể tự tin hơn khi cho phép mô hình thực hiện thêm các vòng kiểm tra bổ sung, thay vì dừng lại sớm để tiết kiệm chi phí.
Claude Code và Claude Platform cũng cung cấp chế độ nhanh (fast mode), với tốc độ nhanh gấp tới 2,5 lần so với chế độ tiêu chuẩn. Giá đầu vào của chế độ nhanh là $8 cho mỗi triệu token và giá đầu ra là $40, phù hợp với các kịch bản có yêu cầu cao hơn về tốc độ phản hồi.
Năng lực bảo mật ngày càng được chú trọng
Anthropic cho biết Opus 5.5 đã đạt điểm số cao nhất trong số các mô hình Claude hiện tại ở đợt kiểm toán hành vi tự động. Bài kiểm tra bao gồm gần 2.000 kịch bản mô phỏng, tập trung vào việc liệu mô hình có vượt giới hạn, thực hiện các hành động khó hoàn tác hay chịu ảnh hưởng bởi prompt injection (tấn công chèn lệnh) hay không.
Trong một bài kiểm tra, số lần Opus 5.5 cố gắng vượt giới hạn ít hơn khoảng 85% so với Opus 5, với tất cả các hành vi liên quan đều thuộc nhóm có mức độ nghiêm trọng thấp và mô hình đã chủ động báo cáo vấn đề. Tuy nhiên, Anthropic cũng thừa nhận rằng việc kiểm tra an toàn không thể phát hiện trước mọi rủi ro trong thực tế.
Do đó, Opus 5.5 đã áp dụng các biện pháp bảo vệ nghiêm ngặt hơn trong lĩnh vực an ninh mạng và sinh học. Việc gỡ lỗi và sửa lỗi trong phát triển phần mềm thông thường vẫn được duy trì, nhưng một lượng lớn các tác vụ an ninh mạng sẽ được chuyển sang cho các mô hình khác. Các tổ chức cần tiến hành nghiên cứu sinh học phải nộp đơn xin cấp phép tương ứng thông qua quy trình thẩm định dự án.
Bài viết đề xuất


