
SpaceX AI ra mắt Grok 4.7: Thế hệ chủ lực cho lập trình và công việc tri thức với mức giá tương đương Grok 4.6
TradingKey - SpaceXAI (bộ phận AI của SPXC, trước đây là xAI) đã ra mắt Grok 4.7 vào ngày 21/9, chính thức định vị đây là thế hệ mô hình có năng lực mạnh mẽ nhất từ trước đến nay của hãng dành cho lập trình và xử lý tri thức. Mức giá vẫn giữ nguyên so với Grok 4.6: 2 USD cho mỗi triệu token đầu vào và 6 USD cho mỗi triệu token đầu ra. Trên CursorBench 4.0, bài kiểm tra đánh giá chuyên biệt các tác vụ lập trình thời lượng dài, Grok 4.7 đạt 46,3%, cao hơn 5,9 điểm phần trăm so với Grok 4.6, cùng khẳng định chính thức xếp mô hình ở ranh giới tối ưu hiệu năng trên giá thành trong cùng phân khúc giá trên bài kiểm tra này.
Trong hai năm qua, việc nâng cao năng lực ở các mô hình chủ lực thường dẫn đến đơn giá token cao hơn: nâng cấp thế hệ, tăng giá, và sau đó chờ đợi toàn ngành từng bước hấp thụ chi phí suy luận. Grok 4.7 đi theo một con đường khác: dù đẩy năng lực lên cao hơn, giá thành và tốc độ suy luận của mô hình vẫn ở mức của Grok 4.6, đi kèm một phiên bản nhanh bổ sung giúp tăng gấp đôi tốc độ đầu ra.
Các thông tin chi tiết được công bố chính thức tập trung vào bốn khía cạnh: những thay đổi trong mô hình cơ sở và quá trình huấn luyện học tăng cường, các so sánh ngang và dọc trên bảy bài kiểm tra chuẩn, cấu trúc chi phí trong các tác vụ thời lượng dài, và hệ thống rào chắn an toàn được viết lại hoàn toàn. Ngoài ra, mô hình này sẵn sàng sử dụng ngay lập tức đồng thời trên Cursor, Grok Build, Grok API, cũng như các khung lập trình và nền tảng định tuyến mô hình của bên thứ ba.
Tuyên bố giá trị cốt lõi của Grok 4.7 tập trung vào ba năng lực: lập trình tác vụ thời lượng dài, tạo tài liệu chuyên nghiệp và các rào chắn an toàn. Cả ba đều áp dụng cùng một cấu trúc giá—cung cấp mức giá và tốc độ tương tự thế hệ trước—trong khi sử dụng phiên bản nhanh để phục vụ các kịch bản nhạy cảm với độ trễ.
Các bài kiểm tra chuẩn chính thức cho thấy sự tiến bộ ở thế hệ mô hình này diễn ra liên tục: CursorBench 4.0 tăng 5,9 điểm phần trăm, Terminal-Bench 4.0 tăng gần gấp đôi, AA Briefcase đạt thêm 111 điểm và mô hình đạt điểm số cao nhất của công ty trên các bài kiểm tra về an ninh sinh học. Đồng thời, mức tuyệt đối 19,6% trên các bài kiểm tra pháp lý và sự dẫn đầu của Fable 5.1 trên bốn bài kiểm tra chuẩn cho thấy đây vẫn là một vòng đua có tranh chấp sòng phẳng giữa các bên chứ không phải sự thay thế một chiều.
Mức Giá và Tốc Độ Giữ Nguyên
Grok 4.7 có giá khởi điểm từ 2 USD cho mỗi triệu token đầu vào và 6 USD cho mỗi triệu token đầu ra, giống hệt Grok 4.6, trong khi vẫn duy trì tốc độ suy luận tương tự. Mô hình cũng có một phiên bản nhanh chính thức, cung cấp tốc độ đầu ra gấp đôi phiên bản tiêu chuẩn với mức giá gấp đôi.
Mức giá này nằm ở phân khúc thấp trong số các mô hình tương đương. Để so sánh, GPT-5.6 Sol có giá 4 USD cho đầu vào và 20 USD cho đầu ra ở gói cao nhất, trong khi Fable 5.1 có giá 10 USD cho đầu vào và 50 USD cho đầu ra ở gói cao nhất. Nếu chỉ so sánh đơn giá đầu ra, Grok 4.7 bằng khoảng một phần ba so với mô hình trước và khoảng một phần tám so với mô hình sau.
Tác động thực tế của việc giữ nguyên giá là chi phí chuyển đổi ở mức dễ kiểm soát. Các nhóm đang sử dụng Grok 4.6 có thể chuyển đổi mô hình trực tiếp trong Cursor hoặc Grok Build và chạy thử nghiệm so sánh với bộ tác vụ hiện có của họ mà không cần thay đổi API hay phương thức gọi.
Cải tiến mô hình
Giai đoạn học tăng cường của Grok 4.7 cũng có thời gian huấn luyện dài hơn, với độ khó tổng thể của các nhiệm vụ huấn luyện được nâng cao và trọng số nghiêng về các bài toán đòi hỏi nhiều giờ để hoàn thành. Kết quả trực tiếp được công bố chính thức là mô hình có khả năng tự kiểm tra các đầu ra tốt hơn và quản lý ngữ cảnh dài.
Một thay đổi khác diễn ra trong các mục tiêu huấn luyện. Grok 4.7 được huấn luyện để hiểu trực tiếp khung điều khiển Grok Bot, mang lại hiệu suất tốt hơn trong các nhiệm vụ trò chuyện và công việc tri thức chung. SpaceXAI đã ra mắt Grok Bot vào ngày 11/8, mô tả đây là một tập hợp các tác tử chạy liên tục, mỗi tác tử được trang bị máy tính riêng, có khả năng làm việc bên trong các công cụ và ứng dụng.
Khả năng tạo tài liệu và bài thuyết trình được điểm qua riêng biệt. Theo công bố chính thức, Grok 4.7 cho thấy những cải tiến rõ rệt so với Grok 4.6 ở cả hai danh mục đầu ra, hoạt động ngang ngửa với các mô hình tiên phong khác.
Bảng điểm cho bảy chỉ số tham chiếu
Grok 4.7 thể hiện tốt hơn trong việc tạo tài liệu và bài thuyết trình. Trong các bài kiểm tra GDPval và AA Briefcase, AI được yêu cầu thực hiện công việc của các chuyên gia như luật sư, điều dưỡng và chuyên viên phân tích tài chính. Grok 4.7 đã vượt trội hơn Grok 4.6 trong cả hai bài kiểm tra chuẩn và đạt hiệu suất ngang tầm với các mô hình tiên phong khác.
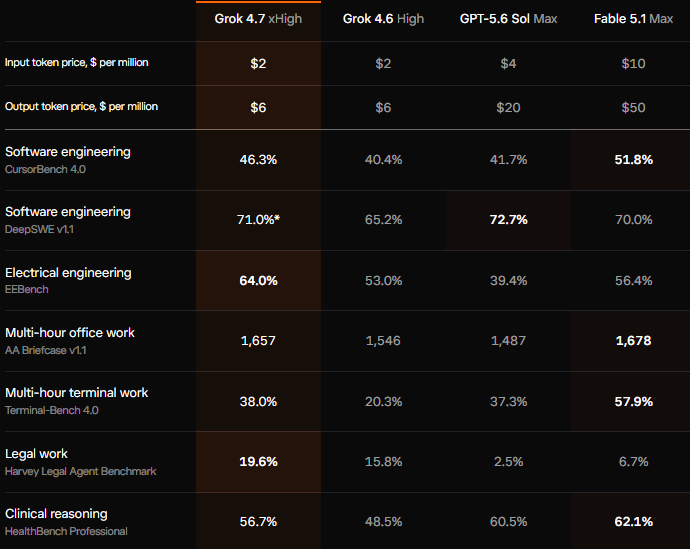
[Bảng so sánh chính thức bao gồm lập trình, thao tác terminal, kỹ thuật điện, luật, tư duy lâm sàng và các tác vụ văn phòng. Nguồn: x.ai]
Lĩnh vực luật và thao tác terminal cho thấy sự cải thiện lớn nhất. Trên bài kiểm tra Harvey Legal Agent Benchmark, Grok 4.7 đạt 19,6%, cao nhất trong nhóm này, trong khi GPT-5.6 Sol chỉ đạt 2,5%; trên Terminal-Bench 4.0, Grok 4.7 đã tăng vọt từ mức 20,3% của Grok 4.6 lên 38,0%, gần như tăng gấp đôi. Tư duy lâm sàng cải thiện 8,2 điểm phần trăm và điểm số tác vụ văn phòng tăng 111 điểm.
Đường cong chi phí trong các tác vụ dài
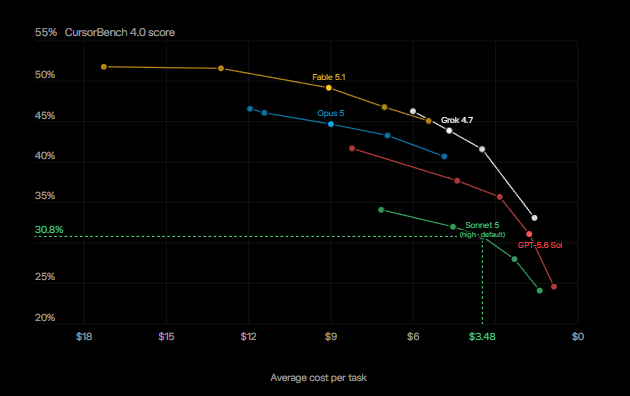
Trang chính thức của CursorBench 4.0 hiển thị ba biểu đồ song song: chi phí trung bình cho mỗi tác vụ, số lượng token đầu ra trung bình và số bước trung bình, trong đó trục tung được chuẩn hóa theo cùng một tập hợp điểm số. Điểm tham chiếu trên các biểu đồ được đánh dấu tại Sonnet 5 (mức thiết lập mặc định cao): điểm số 30,8%, 3,48 USD cho mỗi tác vụ, khoảng 61.000 token đầu ra và 85 bước, đóng vai trò là mốc cơ sở để so sánh hiệu quả chi phí.
[Nguồn: X.ai]
Nhìn vào đường cong chi phí, Fable 5.1 đạt điểm số cao nhất với chi phí gần 18 USD cho mỗi tác vụ; GPT-5.6 Sol nằm ở phía chi phí thấp, với điểm số giảm mạnh hơn khi chi phí giảm. Grok 4.7 nằm ở khoảng giữa hai mô hình này, với các tuyên bố chính thức xếp nó ở ranh giới tối ưu giữa chi phí và hiệu năng trên bài kiểm tra hiệu năng này. Hình dạng của biểu đồ số lượng token đầu ra và số bước hoàn toàn tương đồng với biểu đồ chi phí, cho thấy sự khác biệt về chi phí chủ yếu xuất phát từ độ dài suy luận cần thiết để hoàn thành tác vụ thay vì bản thân đơn giá.
Hãy tưởng tượng một nhóm backend gồm 6 người đang chuyển đổi một dịch vụ 400.000 dòng lệnh từ một framework cũ sang một framework mới. Việc chia nhỏ loại tác vụ này thành các lần commit đơn bước là hoàn toàn không hợp lý; mô hình phải làm việc liên tục trong nhiều giờ và tự kiểm tra kết quả của các bước trước đó trong suốt quá trình—đó chính là kịch bản mà CursorBench 4.0 và Terminal-Bench 4.0 hướng tới để đo lường. Chỉ khi chi phí cho mỗi tác vụ giảm từ hơn 10 USD xuống còn vài USD, các đội ngũ mới có khả năng đưa nó vào lịch trình làm việc hàng ngày, thay vì phải chờ để xử lý theo đợt vào cuối tuần.
Bảo mật và An ninh mạng
Grok 4.7 sử dụng một hệ thống an toàn hoàn toàn mới. Theo công bố chính thức, đây được mô tả là mô hình mạnh nhất của công ty từng được thử nghiệm tính đến nay về cả tỷ lệ từ chối và khả năng chống bẻ khóa.
Trong các lĩnh vực sử dụng kép như an ninh mạng và an ninh sinh học, dữ liệu chính thức bao hàm cả hai khía cạnh: duy trì khả năng sử dụng cho các tác vụ hợp pháp trong khi từ chối các yêu cầu nguy hiểm. Trong lĩnh vực an ninh sinh học, Grok 4.7 đã đạt 62.4% trên bộ kiểm thử an ninh sinh học LatchBio, mức điểm cao nhất trên bộ kiểm thử này. Trong lĩnh vực an ninh mạng, bộ kiểm thử nội bộ HackerBench v0.3 cho thấy mô hình chỉ cho phép 3.3% các câu lệnh sử dụng kép có rủi ro cao, trong khi hiếm khi chặn các nghiên cứu an ninh hợp pháp.
SpaceXAI cũng tuyên bố rằng họ đã bắt đầu cung cấp quyền truy cập theo lời mời đối với các năng lực kiểm thử xâm nhập (red-teaming) của Grok 4.7 cho một số đối tác an ninh mạng được chọn lọc để phục vụ nghiên cứu phòng thủ.
Bài viết đề xuất


